TradingAgents:多智能体交易框架的决策稳定性与投资表现
我用月度回测和重复运行,检查 TradingAgents 的收益取舍、评级一致性,以及它是在下跌前识别风险,还是下跌后才提高防御。
作者:Sam Zhong
TradingAgents 把投资研究拆给不同 AI 角色:分析师收集信息,多头和空头辩论,交易员与风险团队讨论执行,最后由经理给出决策。我想知道,这种看起来很完整的流程,实际能带来多稳定的判断,以及怎样的投资结果。
这篇是我对 TradingAgents 框架和一组回测记录的 review。下文的收益、一致率与相关性来自这组测试,不是项目官网的基准成绩。对我来说,收益表现、决策可重复性、风险识别时机和分析质量必须分别检查;一份漂亮的报告不能代替其中任何一项。
框架怎样形成一次交易判断
官网和我整理的说明把流程分成五层:基本面、情绪、新闻和技术分析师先形成报告;多头与空头研究员讨论相反观点;研究经理汇总辩论;交易员提出交易方案,风险团队从不同风险偏好审视它;最终经理批准或调整决策。
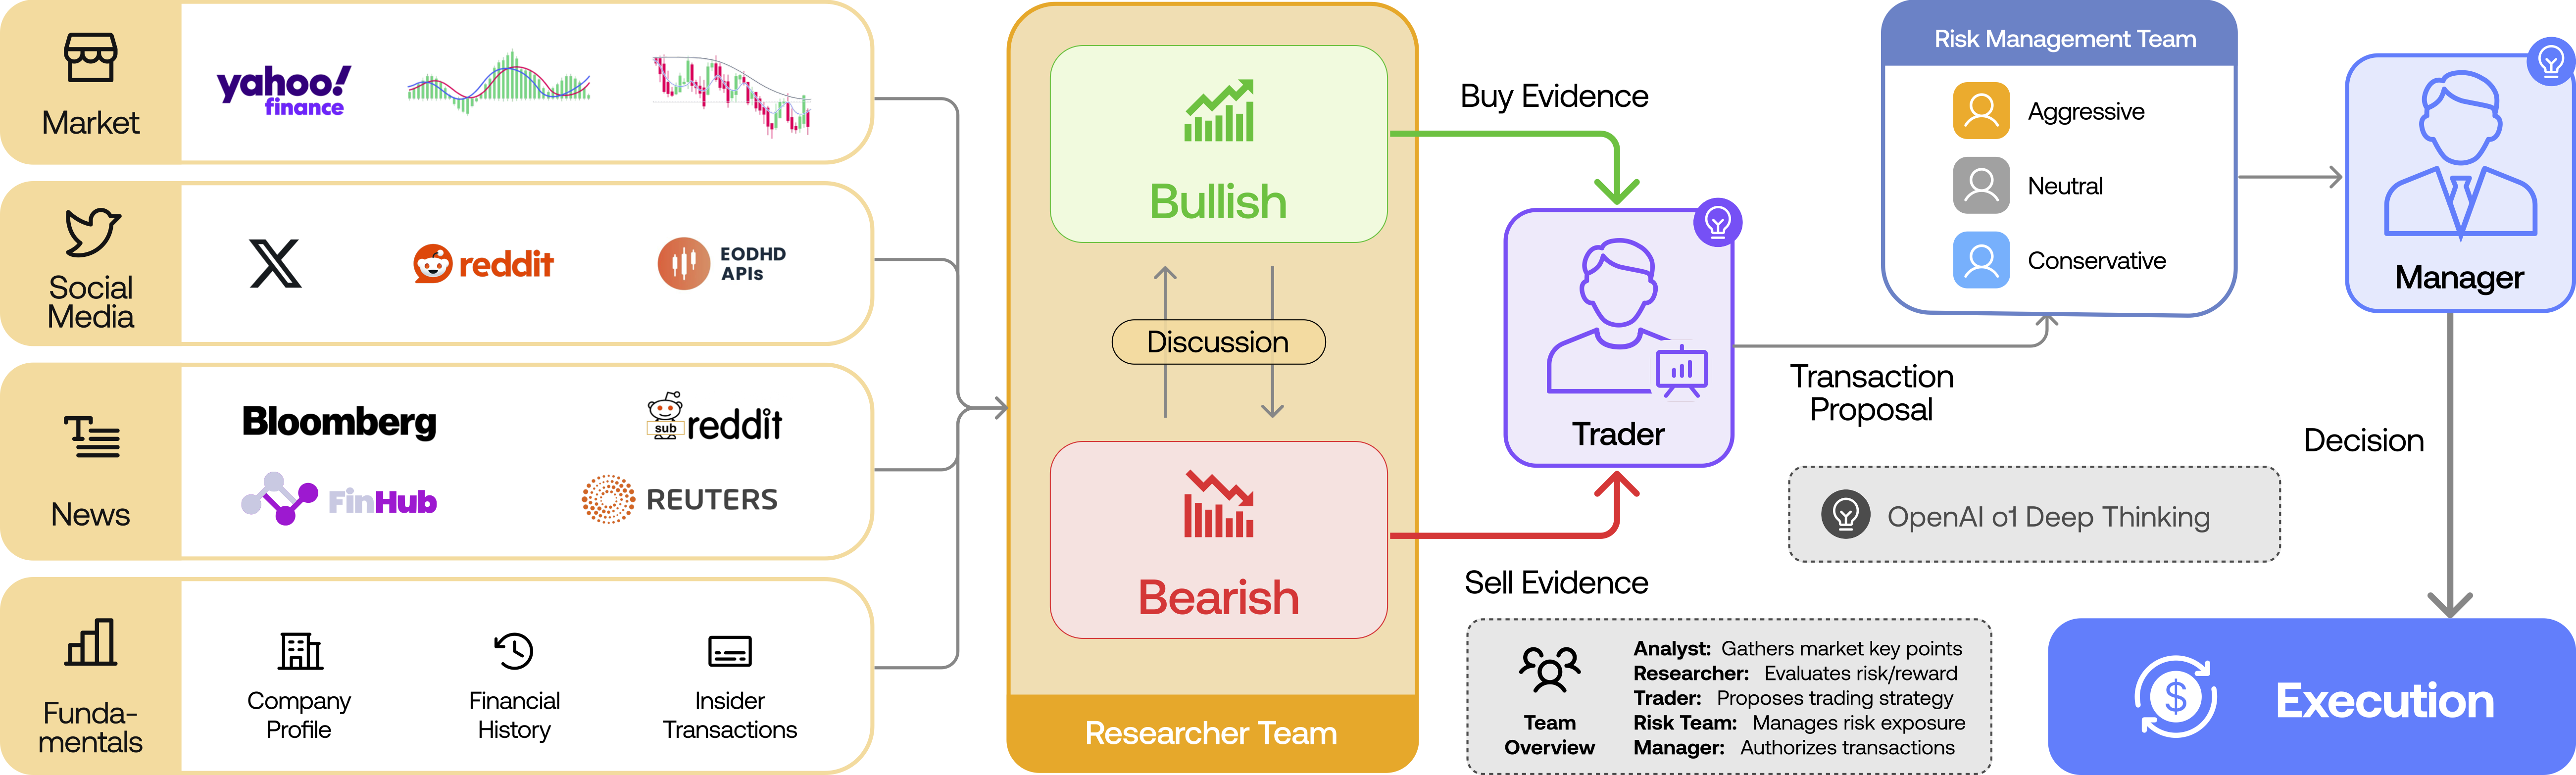
这种分工的好处是每个环节有明确任务,也让中间论据可以被检查。但它仍由多个生成步骤串联:分析师选择哪些事实、多空双方如何解释、研究经理如何取舍,以及历史记忆何时介入,都可能影响最后的评级。只看最终的 Buy 或 Sell,无法定位变化来自哪里。
我的测试:指定股票的月度仓位管理
这组测试使用 Gemini 3.1 Pro。按我的实验设定,模型可用知识截止到 2025 年 1 月;回测从 2025 年 2 月持续到 2026 年 6 月,共 17 个月,每月初评级一次,决策应只使用当时已经公开的信息。这里描述的是实验设定,并不等于已经独立审计过所有数据源的时间戳。
为了把文字评级转成可比较的收益,我把五档评级映射为固定仓位:
| 评级 | 仓位 | 含义 |
|---|---|---|
| Buy | 100% | 满仓 |
| Overweight | 50% | 半仓 |
| Hold | 维持 | 保持上期仓位 |
| Underweight | 25% | 低仓 |
| Sell | 0% | 空仓 |
这是对指定股票调仓的测试:系统不能自己选股,也不能自行构建完整投资组合。美光与 SK 海力士是事后已知上涨的股票,选择它们作为测试对象会限制结论。回测也不能单凭这些数字回答交易成本、滑点、股息、汇率和实际可执行性等问题。
收益:下跌时更稳,上涨时也更容易错过
美光与 SK 海力士上,策略参与了涨幅,但明显落后于买入并持有。再看七只按回测结束后的表现分组的股票,下跌组三只都跑赢买入并持有;横盘组一胜一负;上涨组两只都落后。
| 股票 | 分组 | TradingAgents | 买入并持有 |
|---|---|---|---|
| MU 美光 | 上涨样本 | +335% | +1039% |
| SK 海力士 | 上涨样本 | +270% | +1101% |
| COIN | 下跌组 | +14% | -37% |
| NFLX | 下跌组 | +5% | -12% |
| PYPL | 下跌组 | -2% | -49% |
| MCD | 横盘组 | -7% | -2% |
| META | 横盘组 | -5% | -13% |
| GOOGL | 上涨组 | +75% | +85% |
| WMT | 上涨组 | +7% | +18% |
这体现了降低仓位的两面性:跌时少持有可以减轻损失,涨时少持有也会减少收益。七只股票的分组是根据最终涨跌事后划分的,所以“下跌组表现较好”并不能证明系统提前识别了风险。
重复运行:单月评级不够稳定
同样配置运行两次,美光在 17 个月中只有 6 个月的五档评级完全一致,约 35%;SK 海力士是 7 个月,约 41%。COIN 的另一次比较也是约 7/17;把五档评级合并成更粗的方向后,一致率约 65%。后一种口径允许仓位档位不同,因此自然更容易一致。
单次输出可能只是多种可能判断中的一次。为了区分波动来自哪里,我又固定多空辩论材料,只重复调用研究经理:14 个案例、420 次调用中,11 个案例的方向大体集中,3 个案例则出现明显分歧。这证明研究经理环节可能产生波动,却不能说明它是整个系统最大的随机来源;其他环节还需要同样的控制实验。
最终经理什么时候改变初步方向
在 204 次决策中,研究经理的初步方向与最终评级约有 76% 一致。48 次方向变化里,47 次出现在最终经理给出评级时,只有 1 次发生在交易员阶段。这个统计告诉我变化集中在哪里,仍不能直接证明变化由风险辩论、模型采样或历史记忆中的哪一项造成。
框架会在真实收益出现后回看先前决策,写下反思,并在以后决策中提供历史记忆。有些最终解释会引用这些内容,但提到记忆不等于记忆造成了评级变化。要识别它的因果影响,需要比较关闭记忆、开启记忆和替换记忆内容后的结果。
长期平均较稳定,不代表预测较准确
我把五档评级映射成 0 到 1 的“防御分”:Buy = 0、Overweight = 0.25、Hold = 0.5、Underweight = 0.75、Sell = 1。分数越高,代表越倾向降低仓位。尽管单月评级有明显变化,17 个月的平均防御分在两次运行中相差较小:
| 股票 | 第一次 | 第二次 | 差值 |
|---|---|---|---|
| COIN | 0.735 | 0.691 | 0.044 |
| MU | 0.574 | 0.544 | 0.029 |
| SK 海力士 | 0.382 | 0.426 | 0.044 |
单月不稳定与长期平均较稳定可以同时成立。不过,这里只有两次运行,月份之间也未必独立;平均值接近,不能推导出每次调仓可靠,更不能推导出预测正确。
它是在跌之前识别风险,还是跌之后才保守?
按最终表现分组的平均防御分为:下跌组 0.721、横盘组 0.478、上涨组 0.434。乍看系统似乎更谨慎地对待后来下跌的股票,但这还不能说明它变得谨慎的时间。
在下跌组,防御分与上个月收益的相关性约为 -0.59,与下个月收益的相关性约为 -0.09。前者关系更明显,后者接近没有明显线性关系。现有结果更符合“价格先走弱,系统随后提高防御”的反应式解释;它尚未显示稳定的提前预警能力。相关性并不证明因果关系,而且样本很小,不能把这个判断推广到所有股票或市场环境。
报告写得好,仍须验证论据能否预测
TradingAgents 的多头与空头能够围绕同一事实提出相反、又都听起来合理的解释。例如,一项业务投入既可能意味着未来增长,也可能拖累当期现金流。框架能把论点组织得具体而连贯;但这样的文本不能证明它抓住了决定未来收益的因素,也不能排除关键资料被遗漏。
我的结论
这组测试里,TradingAgents 展示了完整的角色分工,也呈现出较明确的防御倾向:下跌股票上相对占优,上涨股票上则有明显机会成本。重复运行会改变单月评级;聚合后的平均倾向较接近,但稳定不等于正确。时间结构尤其重要:目前的数据更像是在下跌后提高防御,而不是稳定地提前预测下跌。
如果要认真评估它能否用于投资,下一步需要更大的股票样本、更多重复运行、事前定义的选股与分组、交易成本和不确定性区间。还应分别固定或移除记忆、辩论与经理输入,量化每个环节对评级的影响。单次漂亮的收益曲线或一份专业报告,都不足以完成这样的验证。
框架资料:TradingAgents 项目页与开源代码。本文讨论的是上述实验记录,不构成投资建议。